
Как не упираться в лимиты нейросети: 10 правил экономии токенов от IT-Agency
10 ноября
(обн. 10 ноября)
Лимиты — самая частая жалоба при работе с ИИ. В августе 2026 года OpenAI признала восемь багов, которые съедали до 70% недельного лимита, и сбросила пользователям квоты. Разговор о лимитах после этого не утих: выходят подборки и видео «как не упираться в лимиты».
Я нашла способ оптимизировать расход токенов и сейчас поделюсь с вами. Правила экономии универсальны и подходят почти к любой нейросети. В этой статье я рассмотрю их на примере работы с Codex.
Решение не единственно верное — я собирала его из того, что замечала по ходу работы. Если вы только начинаете работать с ИИ, возьмите правила за основу и подстройте под свои задачи.
Карина Тихонова
старший интернет-маркетолог
Как Codex считает лимит
У Codex есть два лимита: на пять часов и на неделю. Когда кончается любой из них, Codex перестаёт брать новые задачи. На продвинутых тарифах пятичасового лимита нет, остаётся только недельный.
Лимит считается в токенах — кусочках слов, из которых нейросеть собирает текст. В расход идёт всё: и то, что агент прочитал, и то, что написал. Перед каждым ответом Codex заново читает переписку в чате, нужные файлы проекта и инструкции. Всё это вместе называется контекстом. Чем больше в контексте лишнего, тем дороже каждое сообщение.
Задачи стоят по-разному. Например, переименовать кнопку на сайте — дёшево. Если Codex читает весь проект и переписывает десяток файлов, лимит уходит в десятки раз быстрее. У двух людей на одном тарифе лимит кончается с разной скоростью: всё зависит от задач.
Поэтому почти все мои правила экономии токенов сводятся к двум целям: чтобы Codex меньше читал и переделывал.
10 принципов экономии лимитов
Чтобы сэкономить лимиты, я придерживаюсь следующих принципов:
1. Даю больше контекста на старте
Исходный промпт пишу подробно: что хочу получить, на какие материалы опираться, как выглядит готовый результат. Codex задаёт меньше уточняющих вопросов. Тогда переписка выходит короче, потому что нет лишнего обмена репликами — ИИ реже перечитывает чат.
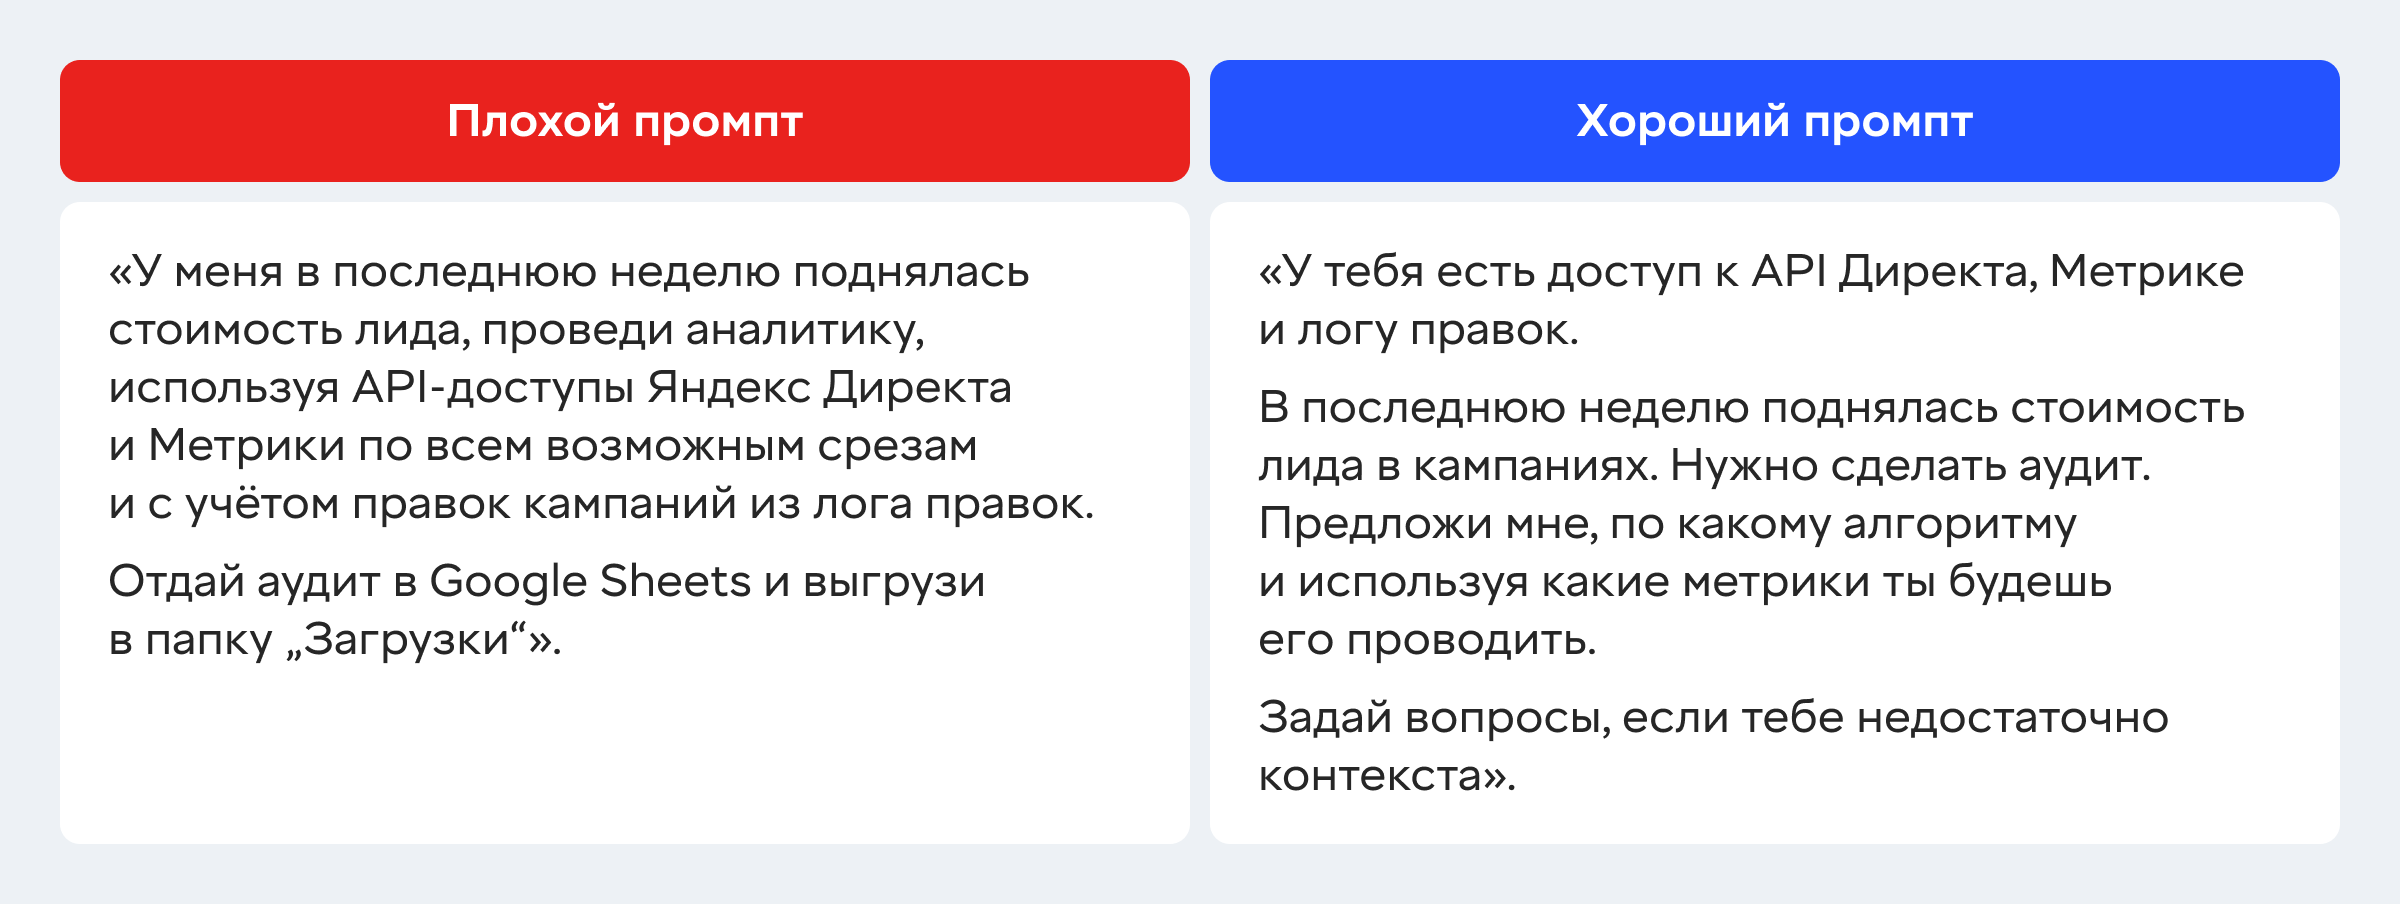
Первый промпт хуже, потому что в таком случае Codex гонит все срезы наугад, и результат часто приходится переделывать. Во втором он сначала согласует со мной план — лишнего чтения и переделок меньше.
2. Делю большую задачу на подзадачи
Мне требовалась полная перенастройка рекламного аккаунта с запуском новых продуктов.
Я не ставила её целиком, а шла по этапам в одном треде:
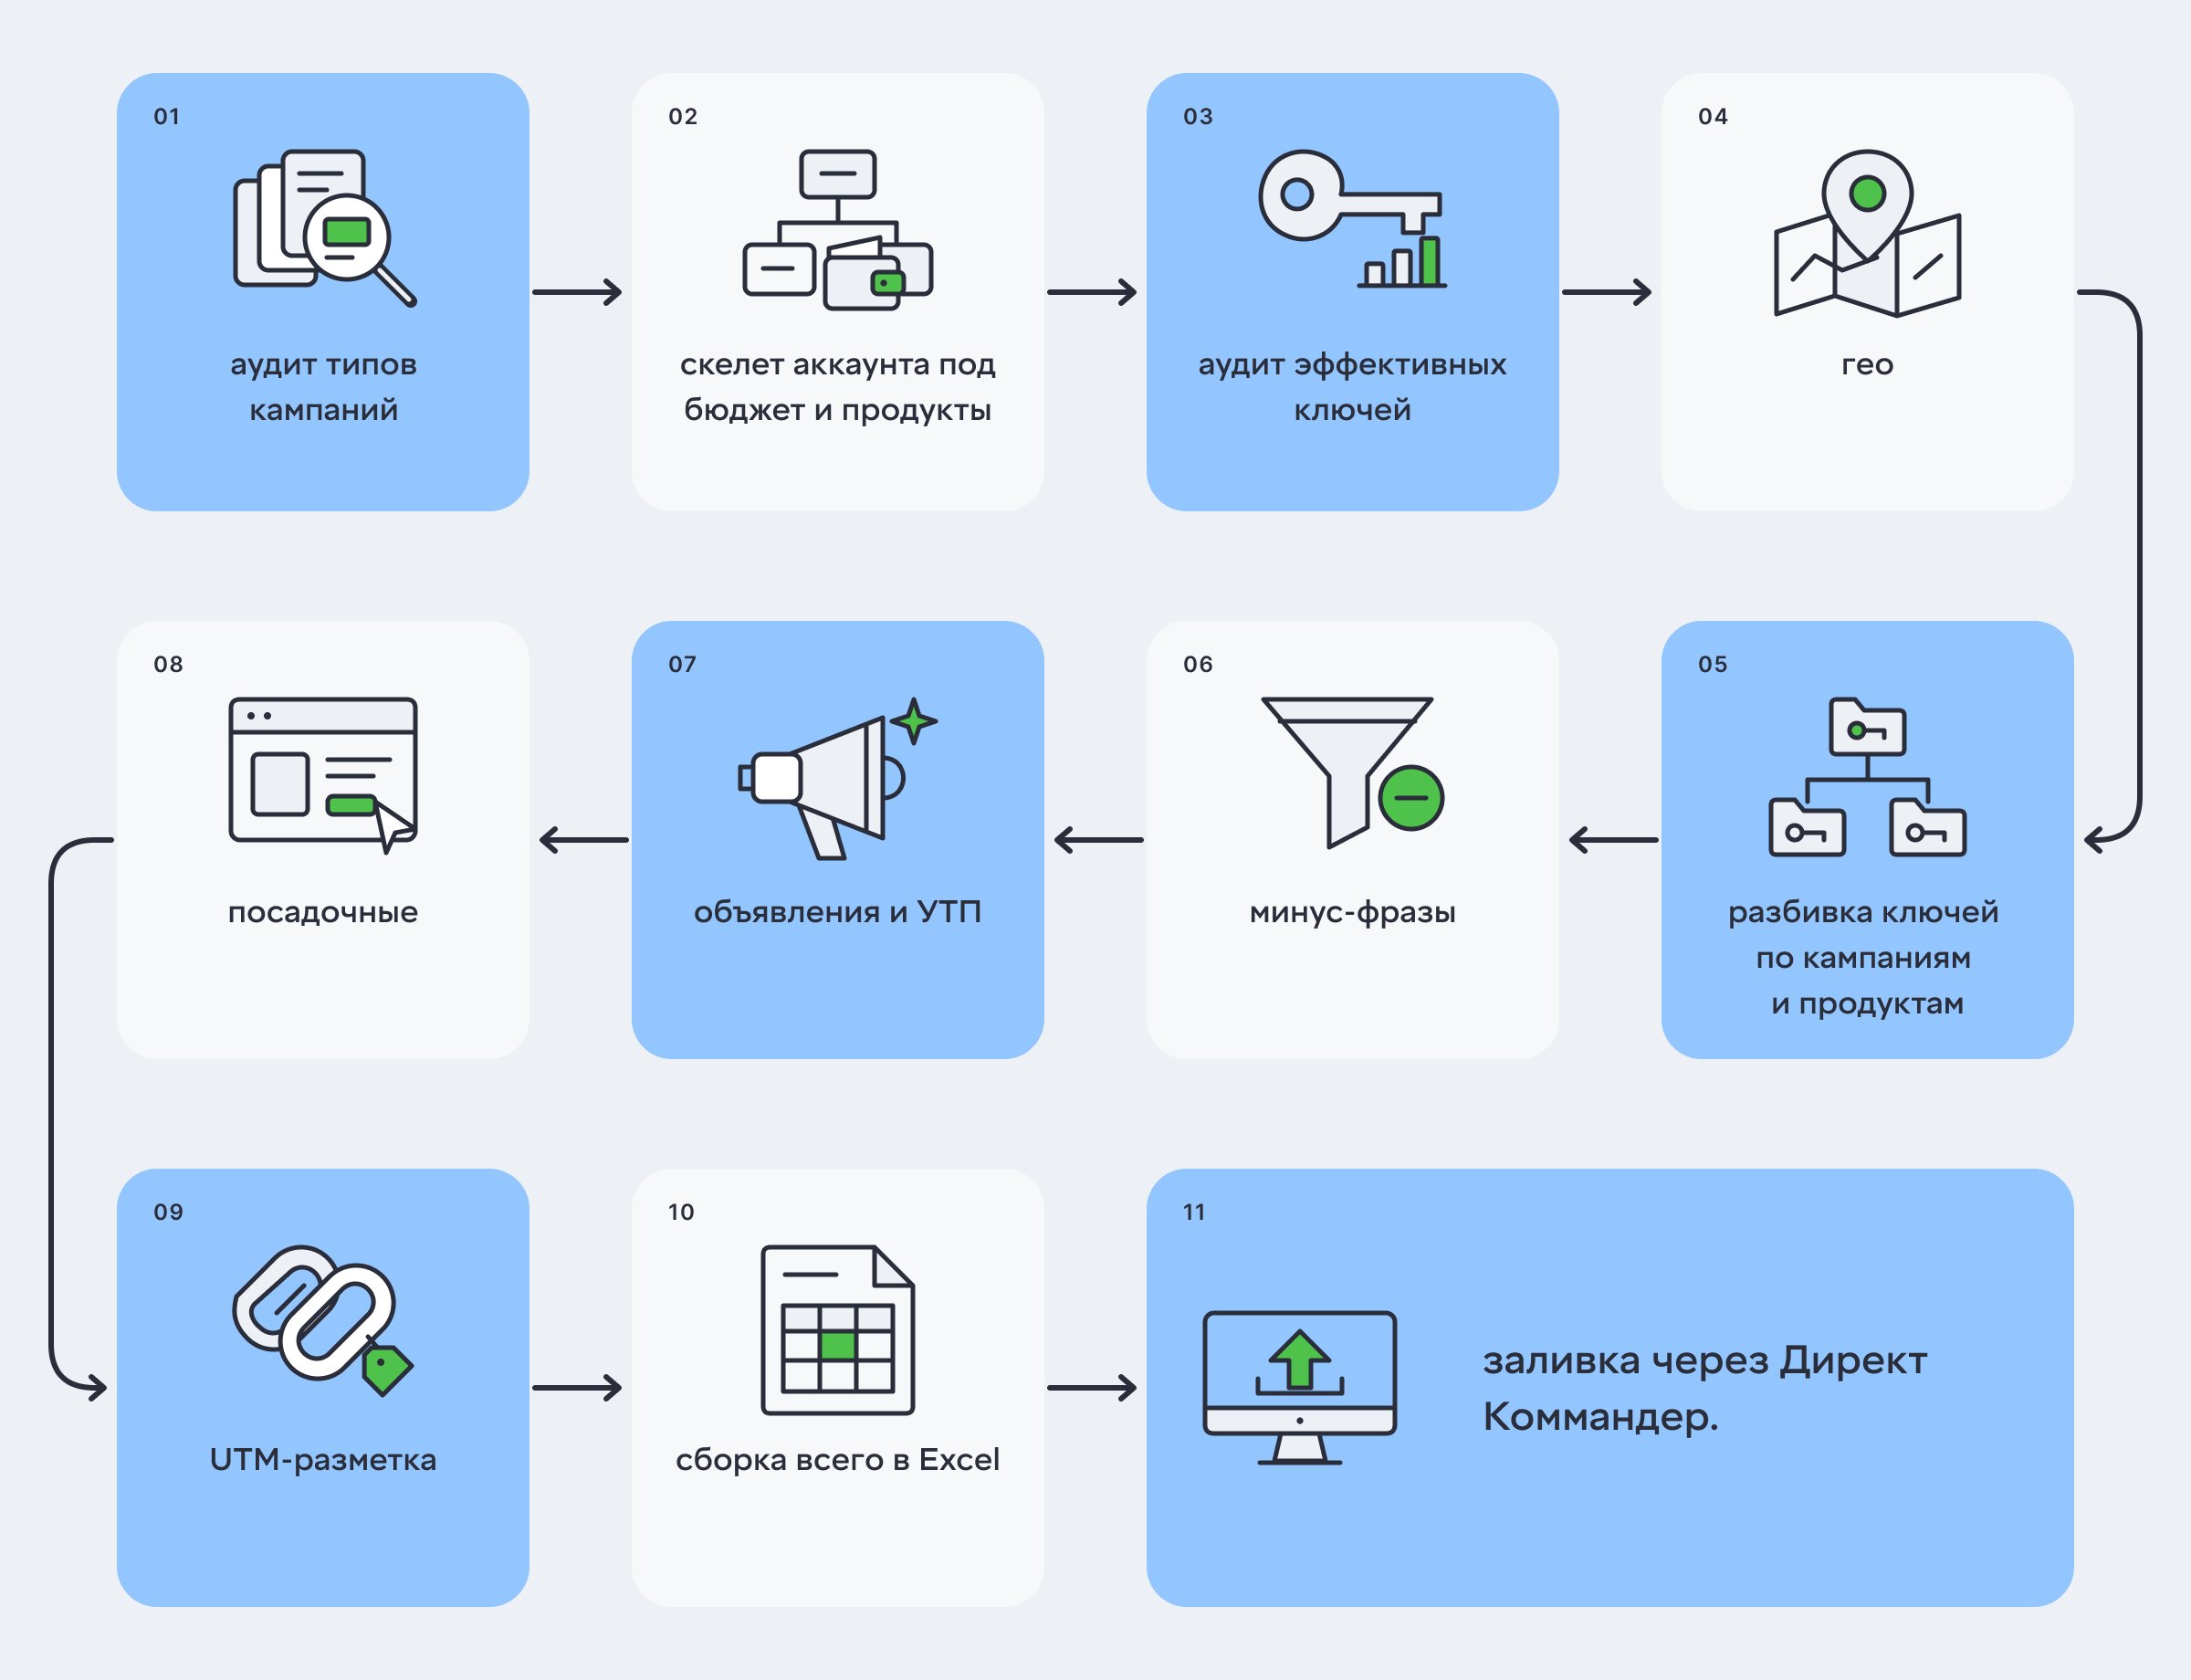
Каждый этап — отдельная задача с проверкой ответов. Итог — 8 новых кампаний за 4,5 часа на аккаунте Директа.
3. Не прошу повторно читать файл
Любое чтение стоит лимита. Если пространство организовано чётко, вам не придется просить Codex погружаться в контекст проекта с каждой новой задачей.
Под каждого клиента у меня есть свой проект в Codex. Вся информация по проекту хранится там. На старте я отдаю Codex всё, кроме персональных данных и проектов под NDA: документы, ссылки, цели — и прошу запомнить.
Дальше ставлю задачу, ничего не напоминая. Например: «Посчитай, как изменился CPL по кампаниям за последнюю неделю». Codex знает контекст и понимает, откуда взять нужную информацию, а уже прочитанное стоит дешевле нового — так экономится лимит.
4. Регулярные задачи — в скилл
Каждый месяц я готовлю медиаплан по одному и тому же шаблону. Раньше каждый раз объясняла Codex, откуда брать данные и как считать, — это длинный промпт и много уточнений. Теперь процесс описан один раз в скилле.
Как я готовлю скилл:
- Отбираю задачу. Критерий простой: задача регулярная или пригодится на других проектах.
- Описываю процесс в отдельном проекте «Автоматизация» — так рабочие папки клиентов не захламляются, а если что-то сломается, я знаю, где искать. Даю Codex вводные: где лежит исходный файл, кто им пользуется, откуда беру данные, что и куда вставляется, как часто обновлять.
- Прошу Codex прочитать файл и источники, разобраться, какие ячейки заполняются вручную, а какие формулами, и оформить всё это в скилл.
- Подключаю скилл в проекте клиента: «Мы автоматизировали подготовку медиаплана, скилл называется X. В этом треде будем обновлять медиаплан по нему каждый месяц».
- Дальше достаточно написать «обнови медиаплан за ноябрь». Codex не нужно ничего объяснять заново — запрос короче, переписки меньше, лимит тратится медленнее.
5. Быстрые вопросы — в отдельный чат
Если посреди большой задачи спросить что-то постороннее, вопрос и ответ остаются в треде, и Codex перечитывает их с каждым следующим сообщением. Поэтому быстрые вопросы я задаю в специально боковом чате, либо в разделе «Недавние», а потом архивирую.
6. Вместо файла Excel даю ссылку на Google-документ
Codex читает Google-таблицу напрямую через плагин Google Drive и берёт только нужный диапазон.
Excel ему сначала нужно разобрать: написать скрипт, вытащить листы, разобраться с формулами и объединёнными ячейками. Всё это попадает в контекст и тратит лимит.
7. Отправлять текст вместо скриншотов
Ошибку или таблицу показываю текстом. Картинка в контексте весит больше, чем текст, и остаётся в переписке — Codex перечитывает её вместе с чатом. А цифры со скриншота он может ещё и распознать с ошибкой.
Среди августовских багов Codex был именно такой — при сжатии контекста сохранялись старые изображения.
8. Выполнять большие задачи до 16:00 по МСК
Заметила, что похожие задачи утром и вечером съедают разное количество лимитов. Вечером — гораздо больше.
Причина простая: после 16:00 по Москве начинается рабочий день в США, растёт нагрузка на серверы. Так что если вы не сова — повезло!
9. Режим «подтверждать за меня» сменить на «всегда спрашивать»
Официально автоподтверждение влияет на автономность агента и на риск, но не на лимиты. У меня вышло иначе. Я включила автоподтверждение и заметила, что повышенный уровень рассуждения быстрее съедает токены.
Сейчас работаю так: средний или высокий уровень рассуждения — только для аналитики и аудита; автоподтверждение — только там, где Codex читает данные, а не меняет их.
Я не утверждаю, что автоподтверждение съедает лимит. Но вместе с высоким уровнем рассуждения оно съело мой.
10. Не ставить параллельные задачи, а запускать по одной
Однажды запустила три задачи сразу: для одного клиента — аудит текущих размещений, для другого — подбор каналов продвижения, и параллельно Codex в режиме goal mode чинил баг в отчётности — это самая тяжелая задача.
Лимит закончился через 20 минут, все три задачи остановились на полпути, и еще пару часов я ждала, пока он восстановится. С тех пор тяжёлые задачи запускаю по одной.
У каждой задачи свой контекст, а лимит общий. Две-три тяжёлые задачи параллельно исчерпывают пятичасовое окно вдвое быстрее, и лимит кончается сразу для всех задач на полпути.
Важное наблюдение: субагенты ускоряют работу, но каждый тратит лимит отдельно — подключаю их, только когда срок важнее лимита.
Чек-лист экономии лимитов в Codex
- Запускайте большие задачи до 16:00 по Москве: вечером, с началом рабочего дня в США, те же задачи съедают больше токенов.
- Давайте больше контекста на старте и просите сначала предложить алгоритм, а не сразу результат.
- Делите большую задачу на подзадачи и ведите их в одном треде.
- Ведите задачи клиента в его проекте: Codex уже знает контекст, и перечитывать файлы не нужно.
- Регулярные задачи оформляйте в скилл.
- Быстрые вопросы задавайте в отдельном чате.
- Давайте ссылку на Google-таблицу вместо файла Excel.
- Отправляйте текст вместо скриншотов.
- Включайте высокий уровень рассуждения только для аналитики и аудита, а автоподтверждение — только когда Codex читает данные, но не меняет их.
- Не запускайте несколько тяжёлых задач одновременно.
Что в итоге
Лимит зависит не столько от тарифа, сколько от того, как много лишней информации читает Codex.
Если работать по правилам, которыми я поделилась, то для повседневных задач хватает стартового тарифа. Когда задач становится больше, есть два решения:
- перейти на тариф выше;
- докупить кредиты, если лимит кончился, а задачу нужно закончить сейчас.
Кредиты удобны для разовых всплесков, тариф выше — если нагрузка держится неделями. В такие периоды время для меня дороже экономии.
Если вы только начинаете работать с Codex, не спешите покупать дорогой тариф: сначала поработайте неделю по этим правилам.
Увеличивать план стоит только если паузы из-за лимита стали регулярными даже при экономии лимитов.
Записала Мария Андреева, отредактировал Сергей Афонин

Эффективность
Промпты
Автоматизация
Инструменты
AI
Подобрали для вас

Ещё по теме
Статьи из Академии
два раза в месяц
Даю согласие на обработку моих данных в соответствии с политикой обработки
Обсудим задачу
Мы свяжемся с вами в течение двух часов, чтобы задать вопросы и обсудить, какую пользу можем принести
Александр Кульгинский
управляющий партнёр